【Llama 中文手册】预填充与解码
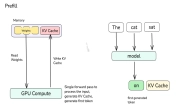
本文深入解析大语言模型推理的两个核心阶段:预填充与解码。预填充阶段处理提示词,受计算能力限制;解码阶段生成答案,受内存带宽限制。文章详细探讨了影响各阶段性能的关键因素,如上下文长度、模型大小及硬件瓶颈。同时介绍了 KV Cache 机制如何加速注意力运算,并分析了 TTFT、TPOT 等用户体验指标及其优化策略,旨在帮助开发者提升推理效率与吞吐量。
关于指标的技术文章和开发文档。
本文深入解析大语言模型推理的两个核心阶段:预填充与解码。预填充阶段处理提示词,受计算能力限制;解码阶段生成答案,受内存带宽限制。文章详细探讨了影响各阶段性能的关键因素,如上下文长度、模型大小及硬件瓶颈。同时介绍了 KV Cache 机制如何加速注意力运算,并分析了 TTFT、TPOT 等用户体验指标及其优化策略,旨在帮助开发者提升推理效率与吞吐量。
本文介绍 API 服务器功能,支持多种格式暴露 REST API。提供 OpenAI 和 Anthropic 兼容端点,涵盖 Chat Completions、Embeddings 及原生补全等。支持结构化输出、工具调用、多模态输入处理,并包含推理模型与性能监控指标,适用于各类 AI 应用场景。