大语言模型推理包含两个不同的阶段:prefill(预填充),即模型读取提示词的阶段;以及 decode(解码),即模型逐 token 生成答案的阶段。虽然两个阶段运行的是同一个模型,但工作内容差异巨大,导致通常由不同的硬件瓶颈主导。
Prefill:读取提示词
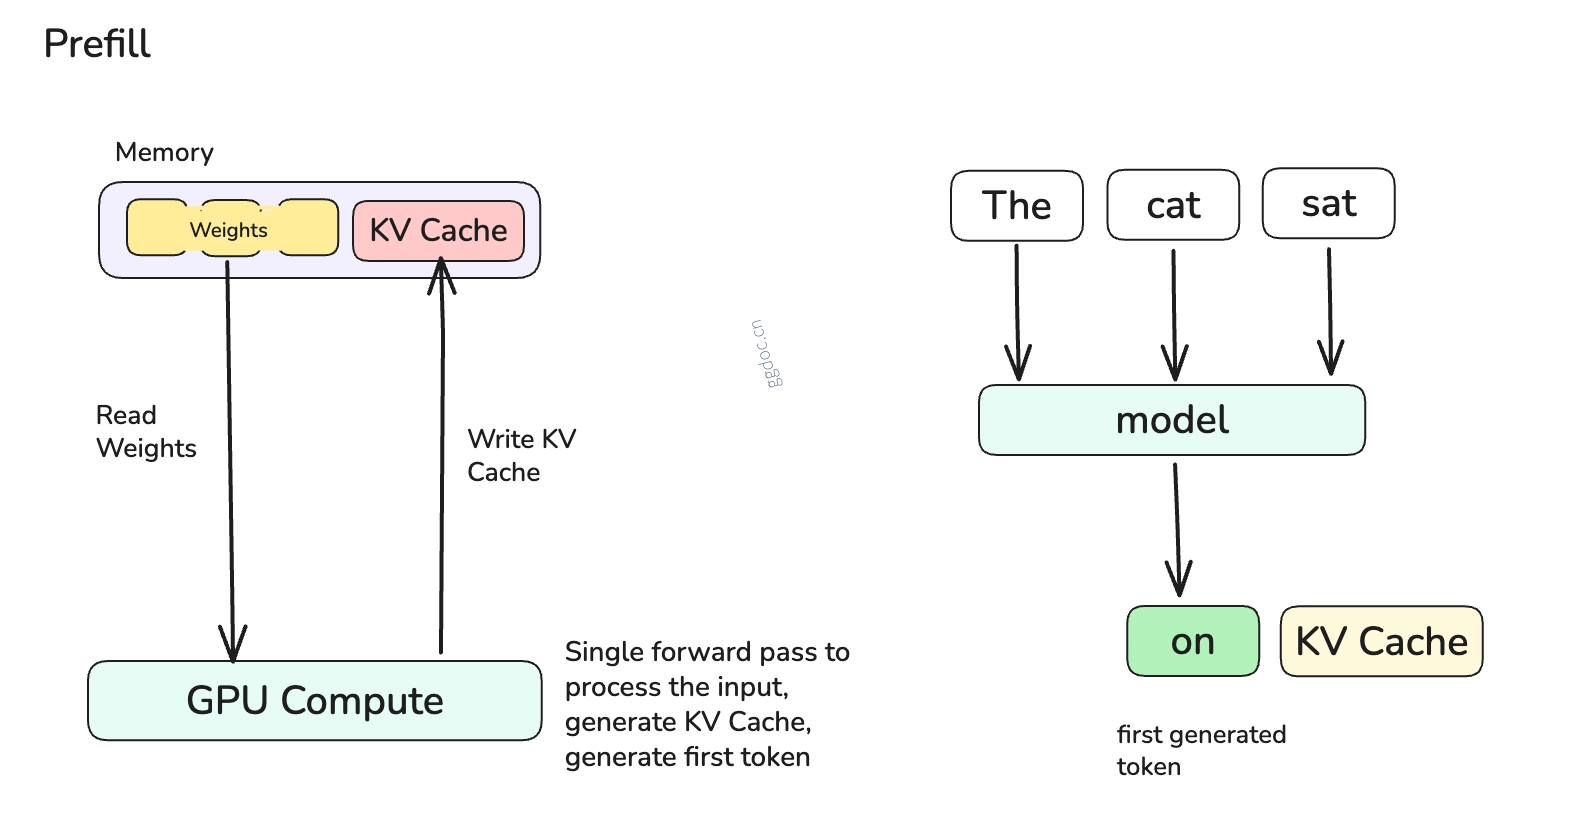
在 prefill 阶段,模型并行处理输入 tokens。每个 transformer 层计算提示词的表示,并将注意力机制的 keys 和 values 存储在 KV cache 中。随后,模型生成第一个输出 token 的概率分布。
这就是 prefill 的样子。我们对模型执行一次遍历:我们读取权重一次以在 GPU 上执行计算,生成第一个 token,并将 KV cache 保存到内存中供后续使用。
影响 Prefill 性能的因素
Prefill 通常是 compute-bound(计算受限)的,因为整个序列是并行处理的。“Compute-bound”是一种说法,意味着你的 GPU 拥有的 flops 越多,prefill 的速度就越快。以下因素会影响 prefill 性能:
- 更长的提示词或更长的上下文
- 更大或计算开销更大的模型
- 较慢的处理器或未充分优化的 kernels
Decode:编写答案
在选择第一个输出 token 后,模型进入自回归循环。模型生成一个 token,然后将其追加到对话中,接着生成新的 token。此过程重复进行,直到生成结束。对于每个生成的 token,模型权重和 KV cache 从内存读取到 GPU,生成该 token,并将新 token 的新 KV cache 写回内存。
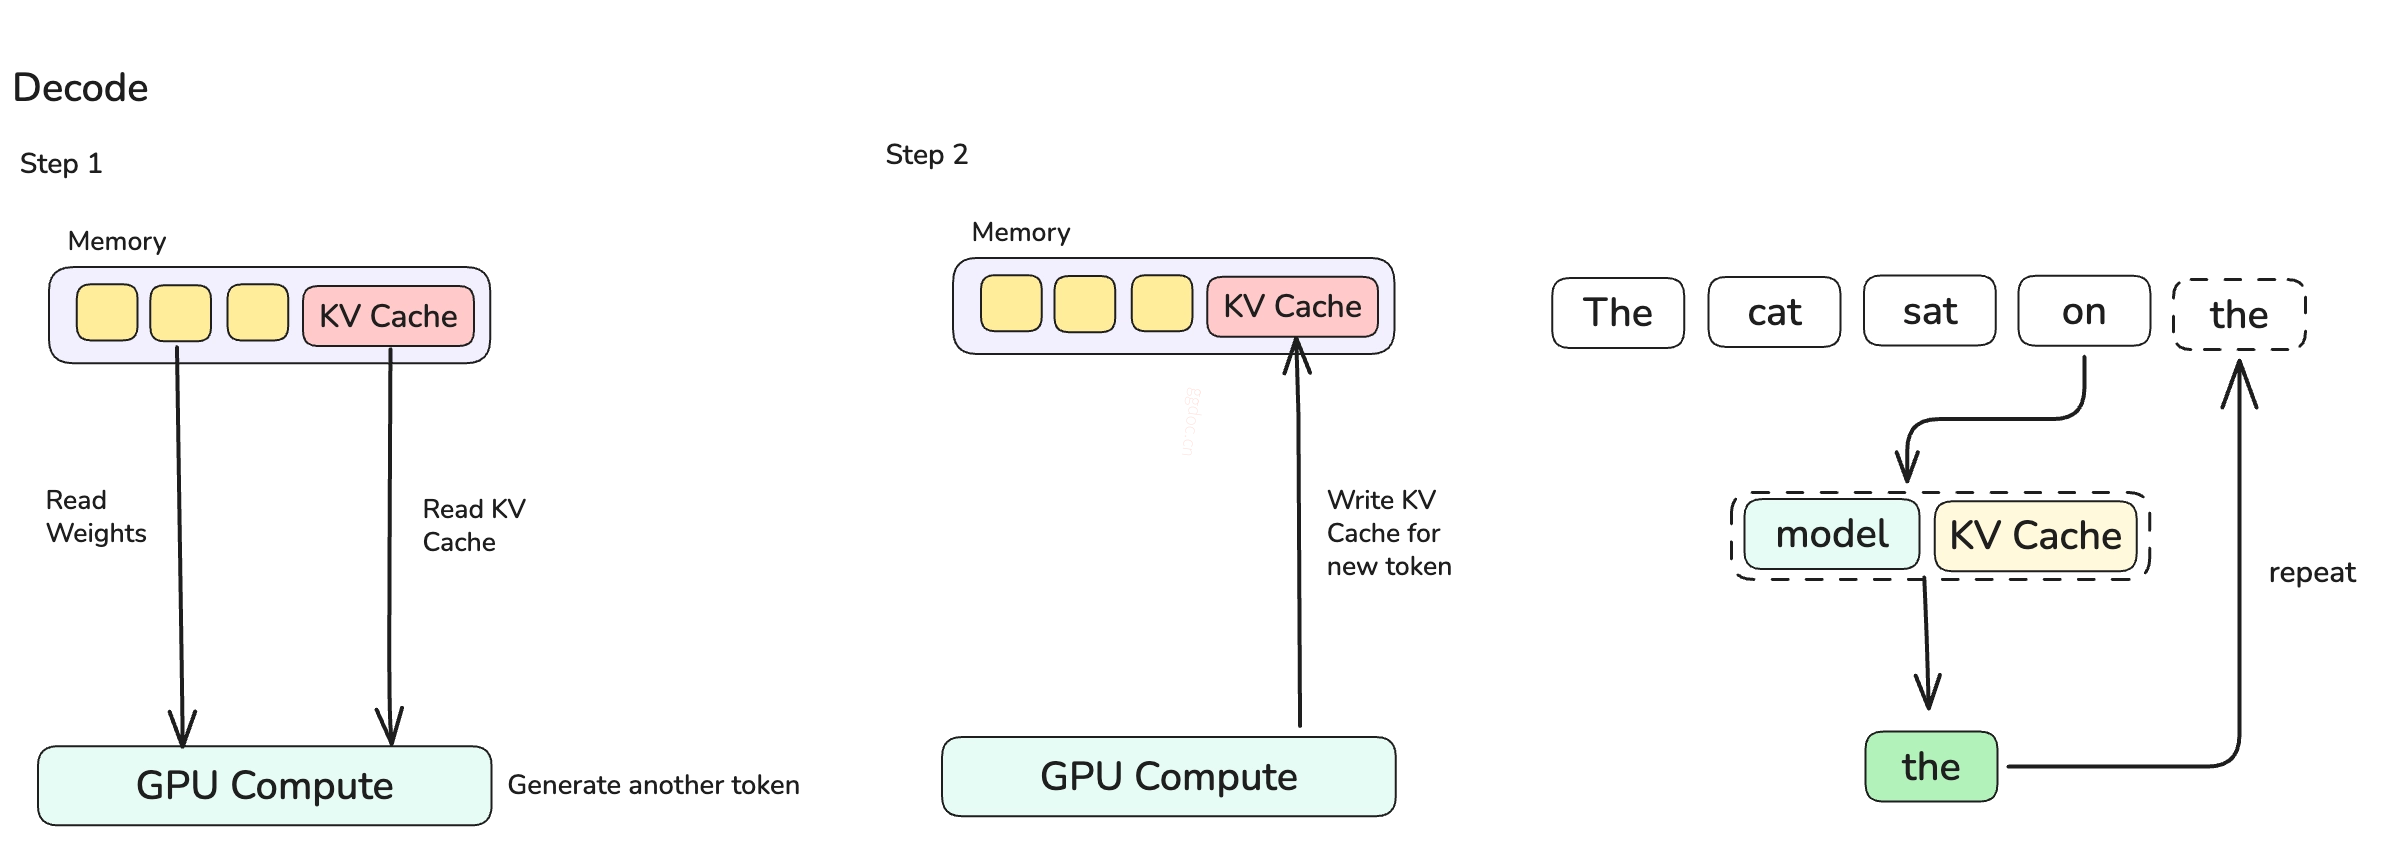
由于这些反复的读/写操作,decode 是 memory-bandwidth-bound(内存带宽受限)的:你能多快地将数据移动到 GPU,生成速度就有多快。生成单个 token 涉及的计算量不大,因此内存传输占主导地位。然而,对输入进行 batching(批处理)有助于最大化计算利用率。当我们一起 decode 多个生成任务时,我们为批次中的所有项目只读取一次权重,GPU 并行地为所有对话生成下一个 tokens。这使得批量生成变为 compute-bound,我们可以获得更好的吞吐量(处理的 tokens 数量增加)。
影响 Decode 速度的因素
- 更大的模型或更高精度的权重
- GPU 内存带宽
- 通过慢速互连进行的 CPU/GPU offloading(卸载)
- 较长的活跃上下文,这会增加 KV-cache 的读取
- 针对模型和硬件未优化 kernels 的实现
Decode 速度通常报告为 output tokens per second(每秒输出 tokens 数)或 time per output token(每个输出 token 的时间)。
KV Cache
KV cache 是一种使 attention 运行更快的技巧。Attention 是 LLMs 的基本组件:每个新 token 的生成都需要查看序列中所有之前的 tokens。因此,它具有二次方复杂度。Attention 由每个 token 的 keys 和 values 组成,但一旦它们被计算出用于序列中的前一个 token,我们就可以缓存结果并在生成新 token 时复用。这增加了额外的内存(随 context window 增长而增加),但使推理速度快得多。在 llama.cpp 中,KV cache 是为给定的 context window 预分配的。在 llama.app 中,你可以看到包括模型和 KV cache 在内的对话所占用的内存量。
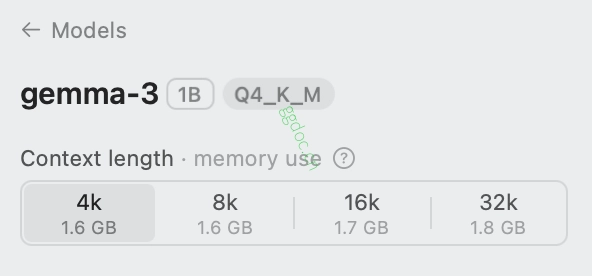
KV cache 的内存消耗取决于模型架构,但我们可以用 number of layers × context length × KV heads × head dim × precision 来近似估算。
因此,长对话有两个成本:
- KV cache 预留或消耗更多内存。
- 每个新 token 需要关注更多缓存的位置,增加了 decode 的工作量和内存流量。
在运行时支持的情况下,开始新对话、总结旧轮次、减少 context limit 或对 KV cache 进行量化可能有所帮助。
映射到用户体验的指标
Time to first token (TTFT)
从你提交初始提示词的时刻到你看到第一个 token 的时刻,因此这与 prefill 有关。
Time per output token (TPOT)
连续生成的 tokens 之间所需的时间,这反映了对话感觉有多快。
Output throughput
每秒生成的输出 tokens 数量。你可以使用 llama bench 对此进行基准测试。
# prefill 128 tokens, generate 64 tokens, run 3 times, benchmark throughput
llama bench -hf ggml-org/gemma-4-e4b-it-GGUF:Q4_0 -p 128 -n 64 -r 3
| model | size | params | backend | threads | test | t/s |
|---|---|---|---|---|---|---|
| gemma3 1B Q4_K | 762.49 MiB | 999.89 M | MTL,BLAS | 5 | pp128 | 2184.32 ± 3.54 |
| gemma3 1B Q4_K | 762.49 MiB | 999.89 M | MTL,BLAS | 5 | tg64 | 115.03 ± 0.19 |
您传入的运行次数(在此示例中为三次)会增加估算的准确性。
Aggregate throughput
每秒所有活跃请求处理的总 token 数。即使这会增加单个请求的延迟,批处理也可能提高此指标。
End-to-end latency
从提交 prompt 到生成结束的时间,大约为 TTFT + number of output tokens × TPOT。
Improving metrics
有许多技巧可以提高吞吐量和内存效率,例如 speculative decoding 或 quantization。这些内容将在其他指南中介绍。