llama cli 是 llama.cpp 的终端前端:一个交互式聊天界面,也是用于试验模型、采样设置、语法和多模态输入的实验场。
基本用法
指向一个模型(本地文件或 Hugging Face 仓库),即可开始聊天:
# 从 Hugging Face 下载(首次运行后会被缓存)
llama cli -hf unsloth/gemma-4-E4B-it-GGUF:Q4_0

# 本地 GGUF 文件
llama cli -m my-model.gguf
你将看到可用命令以及模型的输入选项。
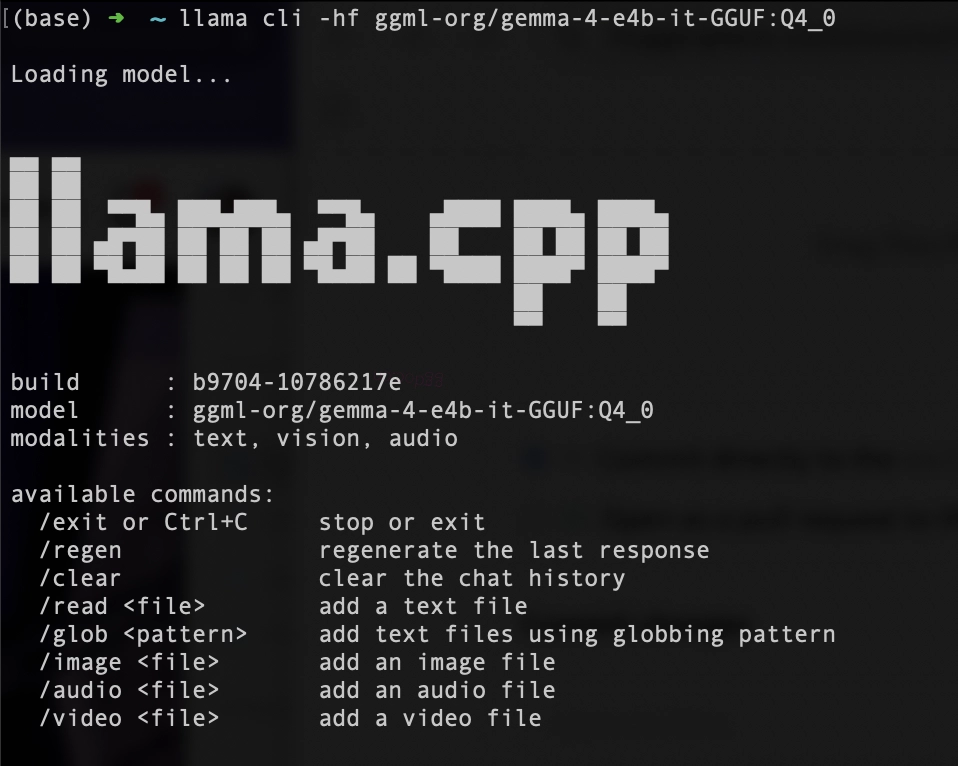
一些提示:
# 设置系统提示词
llama cli -m model.gguf -sys "You are a concise assistant that answers in bullet points."

# 提问一次并在回答结束后退出
llama cli -m model.gguf -st -p "Give me a baklava recipe"
控制生成过程
采样参数决定了模型如何生成文本。llama.cpp 会为你使用的模型选择合理的默认值,但你可以自行实验和调整这些参数:
llama cli -hf ggml-org/gemma-4-e4b-it-GGUF:Q4_0 --temp 0.2 --top-k 40 --top-p 0.95
| 标志 | 默认值 | 作用 |
|---|---|---|
--temp N | 0.8 | 随机性;数值越低越确定 |
--top-k N | 40 | 仅从最可能的 K 个 token 中采样 |
--top-p N | 0.95 | Nucleus sampling 概率质量 |
--min-p N | 0.05 | 丢弃低于此相对概率的 token |
-n, --predict N | -1 | 最大生成的 token 数 (-1 = 无限制) |
--repeat-penalty N | 1.0 | 惩罚重复的 token 序列 |
性能与内存
# 设置上下文窗口大小 (0 = 模型允许的最大上下文长度)
llama cli -m model.gguf -c 16384

# 将 MoE 专家权重保留在 CPU 上;适用于在小 GPU 上运行大型 MoE 模型
llama cli -m model.gguf -cmoe
默认情况下,llama.cpp 会调整未设置的选项以适应可用的设备显存 (--fit on),因此启动时很少出现内存溢出错误。使用 --list-devices 查看可用的 GPU,并使用 -dev 指定特定的 GPU。
多模态输入
许多 LLM 支持图像或多模态输入。启动 llama cli 后,你可以使用 /image 命令向提示中添加图像(媒体文件在前,然后是引用该图像的文本提示):
> /image image.png

Loaded media from 'image.png'

> describe this image
对于一次性的媒体-文本提示,请在提示旁传递媒体文件。
llama cli -hf ggml-org/gemma-4-e4b-it-GGUF:Q4_0 --image "image.png" -p "Describe this image."
同样地,你可以在 CLI 中使用 /audio 处理音频输入,或使用 --audio 处理一次性的音频-文本对。通过逗号分隔的路径允许多个文件。
> /audio /Users/mervenoyan/Downloads/example_audio.mp3

Loaded media from '/Users/mervenoyan/Downloads/example_audio.mp3'

> transcribe this audio
推理模型
对于支持思考/推理功能的模型,你可以控制其思考行为:
# 完全禁用思考功能
llama cli -hf ggml-org/gemma-4-e4b-it-GGUF:Q4_0 -rea off

# 将思考预算限制为 1024 个 token
llama cli -m model.gguf --reasoning-budget 1024
推测解码
使用推测解码助手(或草稿)模型来加速生成。这适用于支持此功能的模型,你需要同时指定主模型和草稿模型:
llama cli -m big-model.gguf -md small-draft-model.gguf --spec-type draft-simple
对于 Hugging Face Hub 上的 GGUF 仓库,你可以指向大模型和小模型仓库。在某些仓库中,它们被放在一起;在其他仓库中,你可以分别指向包含主模型和助手模型的仓库。
llama cli -hf ggml-org/gemma-4-e4b-it-GGUF:Q4_0 --hf-repo-draft ggml-org/gemma-4-e4b-it-GGUF:Q4_0 --spec-type draft-mtp
--spec-type 默认为 none(不使用草稿模型),常见的选择有 draft-simple、draft-mtp 或 draft-eagle3,具体取决于模型支持的草稿风格。
获取帮助
llama cli -h 打印所有选项。这里展示的是一些最常用的标志;完整参考文档记录了更多高级设置。