llama serve 是一条用于启动快速、轻量级 LLM 推理 HTTP 服务器的命令。它提供:
- 一个 OpenAI 兼容 API(聊天补全、补全、嵌入等)
- 内置的 Web UI,可在浏览器中进行聊天
- 支持多用户并行解码和连续批处理
启动服务器
# 从 Hugging Face 仓库获取(自动下载并缓存)
llama serve -hf ggml-org/gemma-4-e4b-it-GGUF:Q4_0

# 从本地 GGUF 文件获取
llama serve -m my-model.gguf
默认情况下,服务器监听 http://127.0.0.1:9931。在浏览器中打开该地址即可访问 Web UI,或向其发送 API 请求:
curl http://localhost:9931/v1/chat/completions \
    -H "Content-Type: application/json" \
    -d '{"messages": [{"role": "user", "content": "Hello!"}]}'
常见配置
llama serve -m model.gguf \
    -c 16384 \ # 上下文大小(传入 0 表示使用模型原生最大值)
    -ngl all \          # GPU 卸载(默认:auto)
    --host 0.0.0.0 \    # 监听所有接口(默认:127.0.0.1)
--port 9931 | 标志 | 功能说明 |
|---|---|
-c, --ctx-size N | 以 token 为单位的上下文大小;-c 0 使用模型的完整上下文窗口 |
-ngl, --gpu-layers N | 卸载到 GPU 的层数(auto、all 或具体数字) |
-np, --parallel N | 用于并发请求的服务器插槽数量(默认:auto) |
--host, --port | 绑定地址和端口(默认 127.0.0.1:9931) |
-a, --alias NAME | API 报告的模型名称 |
--api-key KEY | 要求提供 API 密钥(多个密钥用逗号分隔) |
--no-webui | 禁用 Web UI,仅提供 API 服务 |
每个选项都有对应环境变量形式(显示在 llama serve --help 中),这在容器环境中非常有用:
services:
  llamacpp-server:
    image: ghcr.io/ggml-org/llama.cpp:server
    ports:
      - '9931:9931'
    volumes:
      - ./models:/models
    environment:
      LLAMA_ARG_HOST: '0.0.0.0'
      LLAMA_ARG_MODEL: /models/my_model.gguf
      LLAMA_ARG_CTX_SIZE: 4096
      LLAMA_ARG_N_PARALLEL: 2
      LLAMA_ARG_PORT: 9931
大多数时候,你无需指定许多命令行选项,因为默认值已经合理且经过优化。
服务多用户
服务器开箱即用地处理并发请求。每个并行 slot 持有一个对话;上下文在所有 slot 之间共享:
# 最多 4 个并发请求
llama serve -m model.gguf -c 16384 -np 4
默认启用 Prompt caching,因此具有共享前缀(如系统提示词或正在进行的聊天)的重复请求会跳过重新处理服务器已经见过的内容。
超越聊天:嵌入、重排序、多模态
llama serve 可用于为检索工作流提供嵌入和重排序器服务,并支持多模态模型(图像、音频、PDF)。
# 嵌入服务器(配合 /v1/embeddings 端点使用)
llama serve \
  -hf unsloth/embeddinggemma-300m-GGUF \
  --embedding \
  --port 9931

# 发送文本对
curl http://127.0.0.1:9931/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"input": ["The cat sat on the mat", "A feline rested on a rug"]}'
同样,你可以按如下方式使用 llama serve 来提供重排序模型服务。
# 重排序器(配合 /v1/rerank 端点使用)
llama serve -m reranker-model.gguf --rerank

# Hugging Face Hub 上的重排序器
llama serve \
  -hf ggml-org/Qwen3-reranker-0.6B-Q8_0-GGUF:Q8_0 \
  --embedding --rerank --pooling rank \
  --port 9931

# 查询重排序端点
curl http://127.0.0.1:9931/v1/rerank \
  -H 'Content-Type: application/json' \
  -d '{
    "query": "What is panda?",
    "top_n": 3,
    "documents": [
      "hi",
      "it is a bear",
      "The giant panda is a bear species endemic to China."
    ]
  }'

# {"model":"ggml-org/Qwen3-reranker-0.6B-Q8_0-GGUF:Q8_0","object":"list","usage":{"prompt_tokens":241,"total_tokens":241},"results":[{"index":2,"relevance_score":0.14964470267295837},{"index":1,"relevance_score":0.0058668069541454315},{"index":0,"relevance_score":0.00028348760679364204}]}%
你可以在 Hugging Face Hub 上搜索支持 llama.cpp 的 重排序器 和 嵌入模型。
你可以像运行纯文本模型一样运行任何多模态模型。
llama serve -hf ggml-org/gemma-4-e4b-it-GGUF:Q4_0
服务启动后,你可以通过 webui 使用拖放或下拉菜单发送图片,也可以通过标准的 OpenAI chat 格式发送,详见 API 文档。
推测解码
将模型与一个小型 draft model 配对以加速生成:
llama serve -m big-model.gguf -md small-draft-model.gguf --spec-type draft-simple
对于包含主模型和 drafter 模型(以及独立仓库)的模型仓库,你可以按如下方式启动 llama server。
llama serve \
  -hf ggml-org/gemma-4-e4b-it-GGUF:Q4_0 \
  --hf-repo-draft ggml-org/gemma-4-e4b-it-GGUF:Q4_0 \
  --spec-type draft-mtp
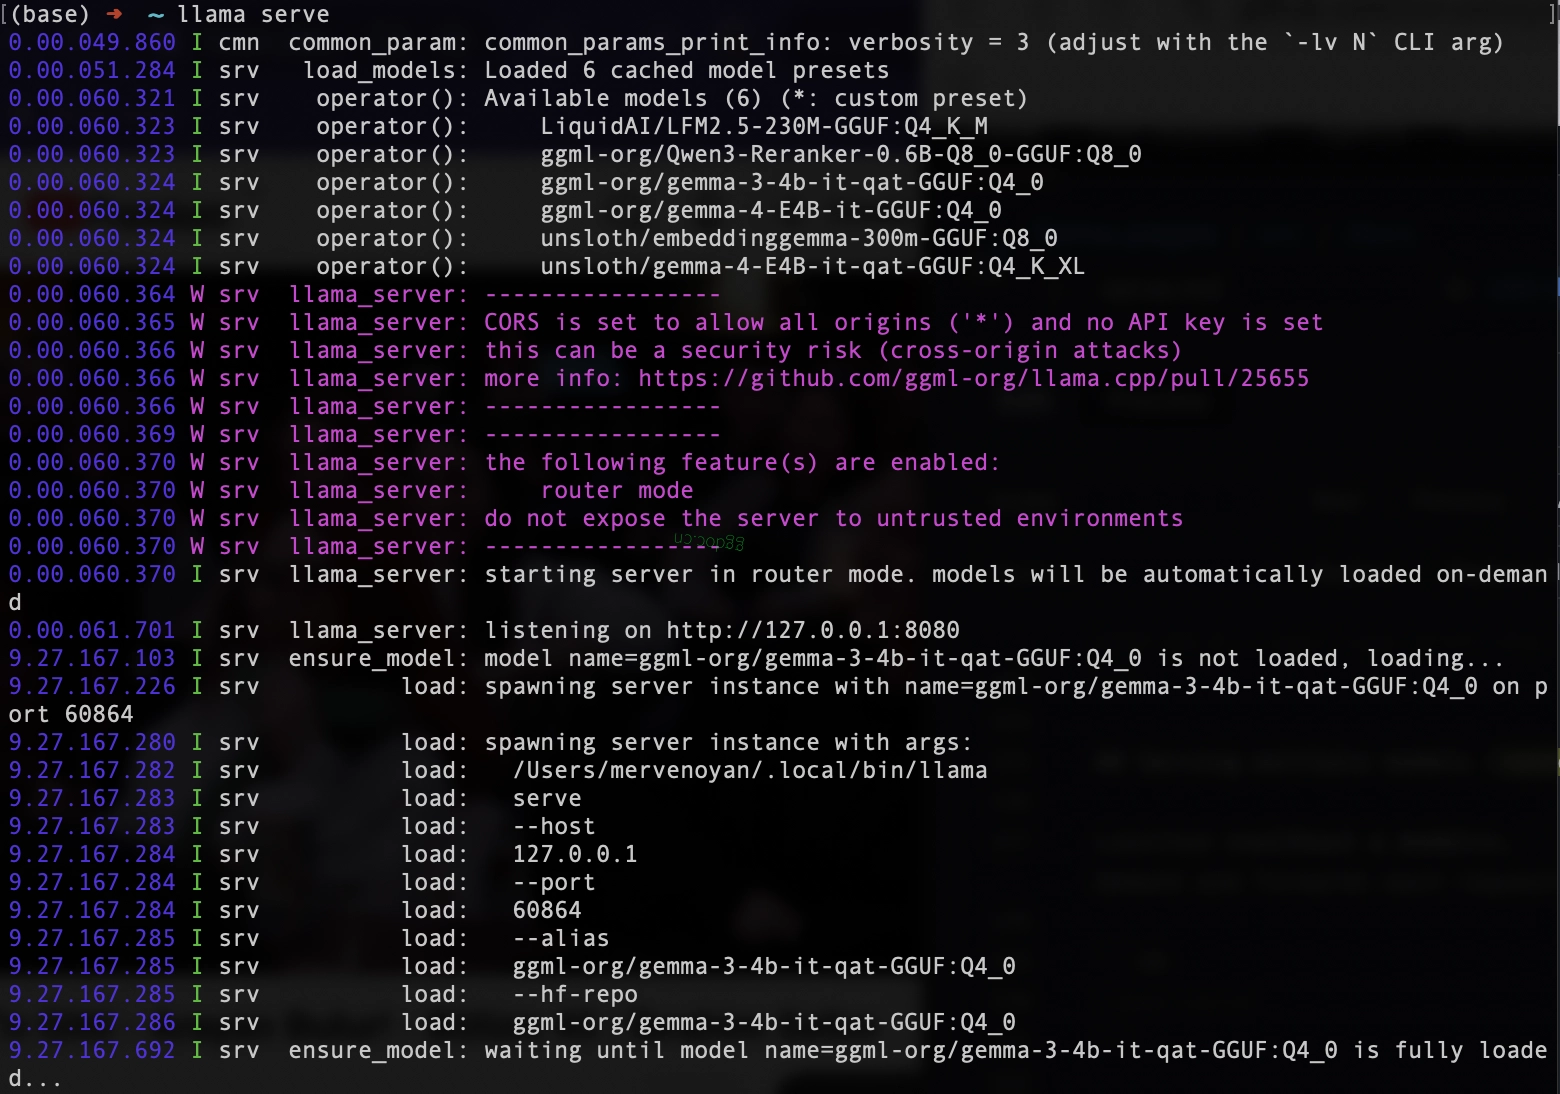
服务多个模型(router 模式)
不加载模型启动时,llama serve 会启动一个 router,按需加载和卸载模型,并将每个请求转发到正确的实例:
llama serve
模型可以来自三个来源:
- 缓存 — 之前通过
-hf下载的任何内容(使用llama serve -cl查看) - 模型目录 —
llama serve --models-dir ./models_directory - 预设文件 —
llama serve --models-preset ./my-models.ini
注意,发送请求时需要指定模型名称。
curl http://localhost:9931/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer no-key" \
  -d '{
    "model": "ggml-org/gemma-3-4b-it-qat-GGUF:Q4_0",
    "messages": [
      {"role": "user", "content": "Hello!"}
    ]
  }'
你可以按如下方式列出可用的模型名称。
(base) ➜  ~ curl -s http://localhost:9931/v1/models | jq '.data[].id'
"LiquidAI/LFM2.5-230M-GGUF:Q4_K_M"
"ggml-org/Qwen3-Reranker-0.6B-Q8_0-GGUF:Q8_0"
"ggml-org/gemma-3-4b-it-qat-GGUF:Q4_0"
服务器会自动加载它进行推理。
有关完整的标志参考,请查看 server README。继续查阅 API 文档 了解端点信息,或查阅 web UI 指南 了解浏览器界面。