基于PHP+FFmpeg+本地大模型的全自动视频字幕翻译方案
基于PHP+FFmpeg+OpenCC+Ollama本地大模型搭建全自动视频字幕翻译系统,Windows离线批量处理MKV视频,自动提取字幕、繁简转换、上下文AI翻译、字幕自动换行,硬压字幕输出MP4,全程不上传素材,保护视频隐私,适合自媒体、教学视频本地化汉化。
关于修改执行时间的技术文章和开发文档。
基于PHP+FFmpeg+OpenCC+Ollama本地大模型搭建全自动视频字幕翻译系统,Windows离线批量处理MKV视频,自动提取字幕、繁简转换、上下文AI翻译、字幕自动换行,硬压字幕输出MP4,全程不上传素材,保护视频隐私,适合自媒体、教学视频本地化汉化。
本文详细介绍如何在Ubuntu 26.04 LTS系统上,利用Ollama和Open WebUI完全离线运行ChatGPT风格的AI助手。无需API密钥或互联网连接,即可在本地CPU上部署Llama 3.2等小型模型。教程涵盖安装步骤、模型选择及浏览器界面配置,确保数据隐私且无持续成本,适合日常代码解释与文本处理任务。
本文介绍2025年AI开发最佳Linux工具。Linux凭借开源、高性能成为人工智能主要平台。文章涵盖TensorFlow、PyTorch等深度学习框架,Scikit-learn、XGBoost等数据科学库,Jupyter、VS Code等开发环境,以及Docker、Kubernetes容器化部署方案。此外还涉及Spark大数据处理、OpenCV计算机视觉和Hugging Face NLP工具,助您高效构建与部署AI模型。
本文详细介绍 Ollama 常见问题解决方案,涵盖 macOS、Windows 及 Linux 系统的模型升级方法、GPU 兼容性检查与配置。内容包括如何通过环境变量调整上下文窗口大小、在 Docker 中启用 GPU 加速、禁用云端功能以保护隐私、设置代理服务器访问模型、优化 Flash Attention 与 K/V 缓存量化以减少内存占用,以及管理并发请求和模型加载策略。
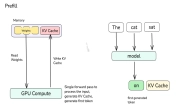
本文深入解析大语言模型推理的两个核心阶段:预填充与解码。预填充阶段处理提示词,受计算能力限制;解码阶段生成答案,受内存带宽限制。文章详细探讨了影响各阶段性能的关键因素,如上下文长度、模型大小及硬件瓶颈。同时介绍了 KV Cache 机制如何加速注意力运算,并分析了 TTFT、TPOT 等用户体验指标及其优化策略,旨在帮助开发者提升推理效率与吞吐量。
本文详细介绍 Ollama 常见故障的排查方法。涵盖如何在不同操作系统(Mac、Linux、Windows)及容器中查看日志,解决 NVIDIA 和 AMD GPU 识别失败问题,处理 Linux noexec 限制,以及修复 Docker cgroup 管理导致的 GPU 切换异常。同时提供强制指定 LLM 库、升级驱动等优化建议,帮助用户快速定位并解决运行难题。
本文介绍 API 服务器功能,支持多种格式暴露 REST API。提供 OpenAI 和 Anthropic 兼容端点,涵盖 Chat Completions、Embeddings 及原生补全等。支持结构化输出、工具调用、多模态输入处理,并包含推理模型与性能监控指标,适用于各类 AI 应用场景。
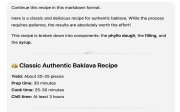
llama.cpp内置现代化Web UI,支持多模态输入与MCPs功能。界面实时流式传输响应,渲染Markdown、LaTeX公式及代码块。支持图像、音频等文件上传,智能识别模型能力。提供对话分支编辑、搜索导入导出功能,可配置JSON schema约束输出,并支持多模型切换与自定义主题设置。
Ollama Web Search API 为模型提供最新信息,减少幻觉并提高准确性。通过创建免费账户获取 API Key 即可访问。该 API 支持 REST 调用及 Python、JavaScript 库集成,能返回网页标题、URL 和内容片段。适用于构建搜索代理或集成至 Cline、Goose 等工具,需确保模型上下文长度足够以处理大量搜索结果。
本文介绍 Ollama 语音模型 Phonon 的使用方法。支持流式传输音频,实现边生成边播放。可配置不同声音,通过终端或 API 调用生成 WAV 格式音频。适用于 macOS、Linux 和 Windows 系统,支持将音频保存至文件或重定向输出,适合服务器环境及远程收听需求。