基于PHP+FFmpeg+本地大模型的全自动视频字幕翻译方案
基于PHP+FFmpeg+OpenCC+Ollama本地大模型搭建全自动视频字幕翻译系统,Windows离线批量处理MKV视频,自动提取字幕、繁简转换、上下文AI翻译、字幕自动换行,硬压字幕输出MP4,全程不上传素材,保护视频隐私,适合自媒体、教学视频本地化汉化。
关于量化的技术文章和开发文档。
基于PHP+FFmpeg+OpenCC+Ollama本地大模型搭建全自动视频字幕翻译系统,Windows离线批量处理MKV视频,自动提取字幕、繁简转换、上下文AI翻译、字幕自动换行,硬压字幕输出MP4,全程不上传素材,保护视频隐私,适合自媒体、教学视频本地化汉化。
本文详细介绍 Ollama 常见问题解决方案,涵盖 macOS、Windows 及 Linux 系统的模型升级方法、GPU 兼容性检查与配置。内容包括如何通过环境变量调整上下文窗口大小、在 Docker 中启用 GPU 加速、禁用云端功能以保护隐私、设置代理服务器访问模型、优化 Flash Attention 与 K/V 缓存量化以减少内存占用,以及管理并发请求和模型加载策略。
本文详细介绍如何在 Ollama 中导入 Safetensors 和 GGUF 格式的大语言模型。教程涵盖使用 Modelfile 创建模型文件、对 GGUF 模型进行量化处理、构建模型以及通过 ollama.com 平台共享模型的完整流程,帮助用户轻松部署和使用自定义 AI 模型。
llama.cpp 是一款高性能库,让您在笔记本或服务器上轻松运行大型语言模型。配套的 Llama app 提供极简桌面体验,支持 Mac 和 Windows。项目支持 GGUF 格式模型,内置 Web 界面及 OpenAI 兼容 API,适合本地部署、终端实验及快速开发,无需复杂配置即可启动服务。
本指南介绍如何快速入门 Llama 应用,从安装到使用终端或 Web UI 与模型对话。支持下载 Gemma-4 E4B 等 GGUF 模型,提供 CLI 命令行交互及 HTTP API 服务化功能。内置聊天界面兼容 OpenAI 端点,支持图像、文本、音频多模态输入,并可根据设备内存自动调整配置,适合开发者快速部署与使用。
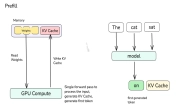
本文深入解析大语言模型推理的两个核心阶段:预填充与解码。预填充阶段处理提示词,受计算能力限制;解码阶段生成答案,受内存带宽限制。文章详细探讨了影响各阶段性能的关键因素,如上下文长度、模型大小及硬件瓶颈。同时介绍了 KV Cache 机制如何加速注意力运算,并分析了 TTFT、TPOT 等用户体验指标及其优化策略,旨在帮助开发者提升推理效率与吞吐量。