本指南假设已经运行着配置了相关 CLI 工具(kubectl、aws、docker)的 Kubernetes 集群、ECS 集群或 Docker/Podman 主机。有关集群设置,请参阅平台文档。
生产环境就绪清单
部署到生产环境前,请确认以下各项:
数据库和 Redis:已 provisioned,可从 AI 服务访问,schema 已创建(PostgreSQL)。
LLM providers:
PROVIDERS已配置并验证;为目标 provider 定义了MODELS。JWT 认证:token 端点已部署,使用 HS256 和正确的 API Secret 进行签名。
TinyMCE 集成:
tinymceai_service_url和tinymceai_token_provider已配置;AI 服务设置了ALLOWED_ORIGINS。容器镜像已拉取,registry 凭据已存为 secret。
反向代理支持 TLS 终止,SSE 设置
proxy_buffering off。通过 Management Panel 创建了 Environment 和 access key。
(可选)MCP 和 web 集成:使用 tool calling 或 web search 时,将 MCP servers 和 web endpoints 部署为同级 Services。
架构概览
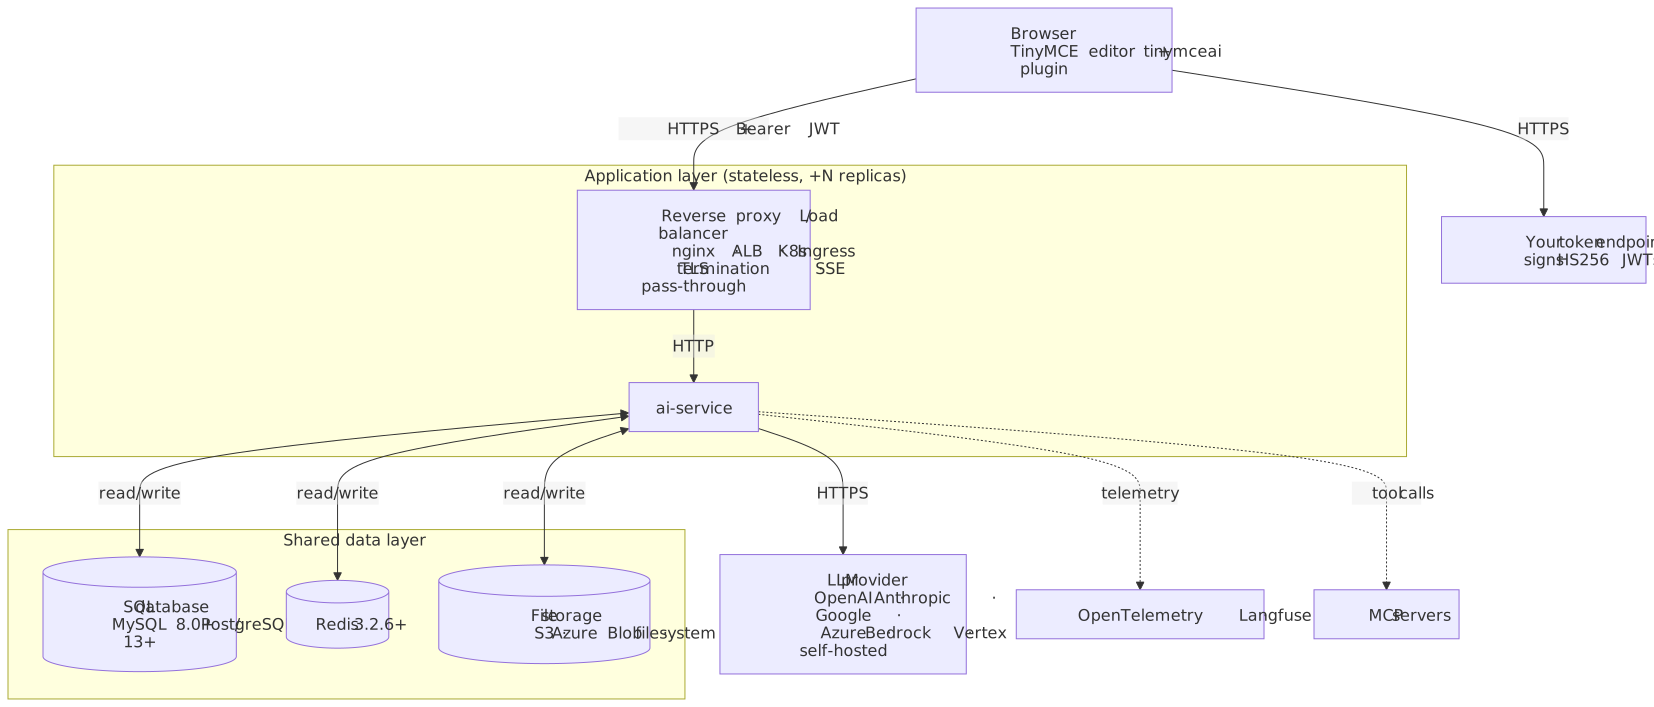
AI 服务是无状态的,将所有状态持久化到 MySQL/PostgreSQL 和 Redis,并在负载均衡器后水平扩展。
TLS / HTTPS
AI 服务不终止 Transport Layer Security (TLS)。需在前面放置反向代理。
代理要求
反向代理或负载均衡器必须满足以下要求:
保持长响应开启。 将 read timeout 和 idle timeout 至少设置为 300 秒,如下例所示。TinyMCE AI 插件本身不设置 request timeout。
不要缓冲响应体。 服务通过 Server-Sent Events (SSE) 流式传输响应。
不要重写
Content-Type响应头。 TinyMCE AI 插件仅在Content-Type完全为application/json时读取POST、PATCH和DELETE请求的响应,仅在完全为text/event-stream时读取流式响应。改变该头的代理,例如添加charset参数,会阻止编辑器读取这些响应。
Nginx 示例
server {
    listen 443 ssl;
    server_name ai.example.com;

    ssl_certificate     /etc/ssl/certs/ai.example.com.pem;
    ssl_certificate_key /etc/ssl/private/ai.example.com.key;

    location / {
        proxy_pass http://ai-service:8000;
        proxy_http_version 1.1;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;

        # SSE streaming support
        proxy_buffering off;
        proxy_cache off;
        proxy_read_timeout 300s;
    }
}
Server-Sent Events (SSE) 流式传输需要
proxy_buffering off。否则,AI 响应看似挂起,直到整个响应生成完成。
AWS ALB
Target group:HTTP 端口 8000
Health check path:
/healthIdle timeout:300 秒(用于长 AI 响应)
Stickiness:不需要(服务无状态)
水平扩展
AI 服务是无状态的。所有持久化状态存储在 SQL 数据库、Redis 和文件存储后端中。负载均衡器后可运行任意数量的副本。所有副本必须共享完全相同的环境变量配置。首次启动或镜像升级后,启动单个副本并等待其 healthy 后再扩展(见 Upgrade process)。
扩展注意事项
| Component | Scaling approach |
|---|---|
AI service | 添加更多容器(无状态) |
MySQL / PostgreSQL | Read replicas 或 managed DB(RDS、Cloud SQL、Azure Database) |
Redis | Redis Cluster 或带内置 replication 的 managed Redis(ElastiCache、Memorystore、Azure Cache)。不支持 Redis Sentinel。 |
File storage | 生产环境推荐 S3 / Azure Blob。 |
首次部署或升级到新版本时,先启动单个实例并等待其 healthy 后再扩展。后续扩展事件不需要此预防措施。
Podman 部署
此示例为简化起见使用 STORAGE_DRIVER='database'。对于生产工作负载,请使用 S3 或 Azure Blob 存储。有关选项,请参阅 文件存储。AI 服务可使用 Podman 作为 Docker 的替代方案。在 Podman 中,Pod 内的容器共享网络命名空间,因此主机名应使用 127.0.0.1 而非容器名称。
podman login -u tiny -p [access-token] registry.containers.tiny.cloud

podman pull registry.containers.tiny.cloud/ai-service-tiny:latest

podman pod create --name ai-pod -p 8000:8000 -p 3306:3306 -p 6379:6379

podman run -d --pod ai-pod --name mysql \
  -e MYSQL_ROOT_PASSWORD=<root-password> \
  -e MYSQL_DATABASE=ai_service \
  mysql:8.0

podman run -d --pod ai-pod --name redis redis:7

podman run --init -d --pod ai-pod --name ai-service \
  -e LICENSE_KEY='T8LK:...' \
  -e ENVIRONMENTS_MANAGEMENT_SECRET_KEY='<management-secret>' \
  -e DATABASE_DRIVER='mysql' \
  -e DATABASE_HOST='127.0.0.1' \
  -e DATABASE_USER='root' \
  -e DATABASE_PASSWORD='<root-password>' \
  -e DATABASE_DATABASE='ai_service' \
  -e REDIS_HOST='127.0.0.1' \
  -e PROVIDERS='{"openai":{"type":"openai","apiKeys":["sk-proj-..."]}}' \
  -e STORAGE_DRIVER='database' \
registry.containers.tiny.cloud/ai-service-tiny:latest请固定使用mysql:8.0。mysql:8标签会浮动到最新的 MySQL,该版本移除了default-authentication-plugin标志,会导致崩溃循环。有关详情,请参阅 Database, Redis, and storage。
Kubernetes 部署
通过五个步骤将 AI 服务部署到 Kubernetes:创建 namespace、存储 secrets、应用 Deployment、作为 Service 暴露以及验证。
第 1 步:Namespace 和镜像拉取 secret
kubectl create namespace tinymce-ai

kubectl create secret docker-registry tiny-registry \
  --namespace tinymce-ai \
  --docker-server=registry.containers.tiny.cloud \
  --docker-username=tiny \
  --docker-password='<registry-access-token>'
第 2 步:应用 secrets
apiVersion: v1
kind: Secret
metadata:
  name: ai-service-secrets
  namespace: tinymce-ai
type: Opaque
stringData:
  license-key: "<license-key>"
  management-secret: "<management-secret>"
  db-password: "<database-password>"
  redis-password: "<redis-password>"
  storage-access-key: "<s3-access-key>"
  storage-secret-key: "<s3-secret-key>"
  providers: |
    {
      "openai": {
        "type": "openai",
        "apiKeys": ["<openai-api-key>"]
      }
    }
在生产环境中,请使用 Sealed Secrets、External Secrets Operator 或 HashiCorp Vault,而非提交原始 secret 清单。有关 Kubernetes Secret 资源本身,请参阅 Kubernetes Secrets 文档。
第 3 步:Deployment
Kubernetes Deployment manifestapiVersion: apps/v1
kind: Deployment
metadata:
name: ai-service
namespace: tinymce-ai
spec:
replicas: 2
selector:
matchLabels:
app: ai-service
template:
metadata:
labels:
app: ai-service
spec:
terminationGracePeriodSeconds: 300
imagePullSecrets:
- name: tiny-registry
containers:
- name: ai-service
image: registry.containers.tiny.cloud/ai-service-tiny:latest
ports:
- containerPort: 8000
env:
- name: LICENSE_KEY
valueFrom:
secretKeyRef:
name: ai-service-secrets
key: license-key
- name: ENVIRONMENTS_MANAGEMENT_SECRET_KEY
valueFrom:
secretKeyRef:
name: ai-service-secrets
key: management-secret
- name: DATABASE_DRIVER
value: "mysql"
- name: DATABASE_HOST
value: "mysql.tinymce-ai.svc.cluster.local"
- name: DATABASE_USER
value: "ai_service"
- name: DATABASE_PASSWORD
valueFrom:
secretKeyRef:
name: ai-service-secrets
key: db-password
- name: DATABASE_DATABASE
value: "ai_service"
# 对于 PostgreSQL:设置为 "public" 或确保 cs-on-premises 模式存在
# - name: DATABASE_SCHEMA
# value: "public"
- name: REDIS_HOST
value: "redis.tinymce-ai.svc.cluster.local"
- name: REDIS_PASSWORD
valueFrom:
secretKeyRef:
name: ai-service-secrets
key: redis-password
- name: PROVIDERS
valueFrom:
secretKeyRef:
name: ai-service-secrets
key: providers
- name: STORAGE_DRIVER
value: "s3"
- name: STORAGE_REGION
value: "us-east-1"
- name: STORAGE_BUCKET
value: "example-ai-storage-bucket"
- name: STORAGE_ACCESS_KEY_ID
valueFrom:
secretKeyRef:
name: ai-service-secrets
key: storage-access-key
- name: STORAGE_SECRET_ACCESS_KEY
valueFrom:
secretKeyRef:
name: ai-service-secrets
key: storage-secret-key
- name: ALLOWED_ORIGINS
value: "https://app.example.com"
- name: ENABLE_METRIC_LOGS
value: "true"
readinessProbe:
httpGet:
path: /health
port: 8000
initialDelaySeconds: 10
periodSeconds: 5
livenessProbe:
httpGet:
path: /health
port: 8000
initialDelaySeconds: 30
periodSeconds: 10
resources:
requests:
memory: "512Mi"
cpu: "500m"
limits:
memory: "2Gi"
cpu: "2000m"对于 PostgreSQL,将DATABASE_DRIVER更改为"postgres",更新DATABASE_HOST为 PostgreSQL 端点,并添加设置为"public"的DATABASE_SCHEMA(或确保cs-on-premises模式存在)。参见 PostgreSQL 模式前提条件。
将 terminationGracePeriodSeconds 设置为 300 以匹配最长 SSE 流持续时间。在收到 SIGTERM 信号时,服务会在关闭前完成正在进行的 SSE 流。将该值设置为等于或大于最长预期 AI 响应时间。这些资源值是评估默认值;请根据生产工作负载进行调整。工作负载为网络 I/O 密集型(等待 LLM 提供商的流式响应),而非 CPU 密集型。基于 CPU 的 HPA 扩缩容是一个安全的起始方案,但在高并发下可能不会触发。对于生产环境,建议通过 KEDA 或 Prometheus Adapter 使用自定义指标(并发 SSE 流数量、请求队列深度)进行补充。
高可用性基础组件
任何多副本部署都应包含以下 Kubernetes 基础组件 — 请按照平台团队的标准进行配置:
PodDisruptionBudget:防止在节点维护期间所有副本同时被驱逐(minAvailable: 1或按比例设置)。podAntiAffinity:将副本分布在不同节点上以避免单节点故障。topologySpreadConstraints:将副本分布在不同可用区以实现区域级弹性。
上述标准 Deployment 示例未包含这些配置 — 它们是站点特定的。若不设置这些配置,调度器可能会将所有副本打包到单个可用区内的单个节点上。软规则也可能产生相同结果:在具有剩余容量的集群中,preferredDuringSchedulingIgnoredDuringExecution 反亲和性和 whenUnsatisfiable: ScheduleAnyway 仍会让调度器将所有副本放在同一节点上。要强制跨区分布,请在可用区拓扑分布约束中设置 whenUnsatisfiable: DoNotSchedule。对于两个节点的情况,节点驱逐或滚动重启仍可能导致少量请求失败,因此建议至少规划三个节点。
步骤 4:Service
apiVersion: v1
kind: Service
metadata:
  name: ai-service
  namespace: tinymce-ai
spec:
  selector:
    app: ai-service
  ports:
    - port: 8000
      targetPort: 8000
第5步:引导环境
当第一个 pod 达到 Ready 状态后,通过管理面板创建环境和访问密钥:
访问位于
https://<ingress-host>/panel/的管理面板。使用
ENVIRONMENTS_MANAGEMENT_SECRET_KEY登录。创建一个环境,并记下 Environment ID。
创建访问密钥并立即复制 API Secret(仅显示一次)。
这些值是 token 端点所需的。有关详细信息,请参阅入门指南 — 创建环境和访问密钥。
请始终通过管理面板 UI 创建环境。
Ingress
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: ai-service
  namespace: tinymce-ai
  annotations:
    nginx.ingress.kubernetes.io/proxy-buffering: "off"
    nginx.ingress.kubernetes.io/proxy-read-timeout: "300"
    nginx.ingress.kubernetes.io/proxy-send-timeout: "300"
spec:
  tls:
    - hosts:
        - ai.example.com
      secretName: ai-tls-cert
  rules:
    - host: ai.example.com
      http:
        paths:
          - path: /
            pathType: Prefix
            backend:
              service:
                name: ai-service
                port:
                  number: 8000
Pod 水平自动扩缩容
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: ai-service-hpa
  namespace: tinymce-ai
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: ai-service
  minReplicas: 2
  maxReplicas: 20
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 70
AI 服务是 I/O 密集型的(等待 LLM 提供商的响应)。基于 CPU 的自动扩缩容是一个安全的起始方案,但如果 CPU 使用率保持较低,在高并发情况下可能不会触发。对于生产环境,建议通过 KEDA 或 Prometheus Adapter 补充自定义指标(并发 SSE 流、请求队列深度)。关于 HPA 配置,请参阅 Kubernetes HPA 文档。
AWS ECS / Fargate
任务定义
完整的 ECS Fargate 任务定义{
"family": "ai-service",
"networkMode": "awsvpc",
"requiresCompatibilities": ["FARGATE"],
"cpu": "1024",
"memory": "2048",
"containerDefinitions": [
{
"name": "ai-service",
"image": "registry.containers.tiny.cloud/ai-service-tiny:latest",
"portMappings": [{ "containerPort": 8000 }],
"healthCheck": {
"command": ["CMD-SHELL", "wget -q --spider http://localhost:8000/health || exit 1"],
"interval": 30,
"timeout": 5,
"retries": 3,
"startPeriod": 60
},
"secrets": [
{ "name": "LICENSE_KEY", "valueFrom": "arn:aws:secretsmanager:us-east-1:111122223333:secret:ai-license" },
{ "name": "ENVIRONMENTS_MANAGEMENT_SECRET_KEY", "valueFrom": "arn:aws:secretsmanager:us-east-1:111122223333:secret:ai-mgmt-secret" },
{ "name": "DATABASE_PASSWORD", "valueFrom": "arn:aws:secretsmanager:us-east-1:111122223333:secret:ai-db" },
{ "name": "PROVIDERS", "valueFrom": "arn:aws:secretsmanager:us-east-1:111122223333:secret:ai-providers" },
{ "name": "MODELS", "valueFrom": "arn:aws:secretsmanager:us-east-1:111122223333:secret:ai-models" }
],
"environment": [
{ "name": "DATABASE_DRIVER", "value": "mysql" },
{ "name": "DATABASE_HOST", "value": "example-rds-endpoint.region.rds.amazonaws.com" },
{ "name": "DATABASE_USER", "value": "ai_service" },
{ "name": "DATABASE_DATABASE", "value": "ai_service" },
{ "name": "REDIS_HOST", "value": "example-elasticache-endpoint.region.cache.amazonaws.com" },
{ "name": "STORAGE_DRIVER", "value": "s3" },
{ "name": "STORAGE_BUCKET", "value": "example-ai-storage-bucket" },
{ "name": "STORAGE_REGION", "value": "us-east-1" },
{ "name": "ALLOWED_ORIGINS", "value": "https://app.example.com" },
{ "name": "ENABLE_METRIC_LOGS", "value": "true" }
]
}
]
}AI 服务在访问 S3 时不使用 ECS 任务角色凭证。请从 AWS Secrets Manager 添加STORAGE_ACCESS_KEY_ID和STORAGE_SECRET_ACCESS_KEY作为 secrets 条目。
AI 服务不使用平台原生的凭证链。AWS IRSA、EC2 实例配置文件、GCP Workload Identity 和 Azure Managed Identity 都会被忽略。所有提供商凭证(LLM 密钥、S3 访问密钥、Vertex 服务账户)都必须显式地作为环境变量提供。这是一个适用于所有部署目标的已知限制。
基础设施建议
| 服务 | AWS 建议 |
|---|---|
数据库 | RDS for MySQL 8.0(Multi-AZ 用于高可用性 (HA)) |
Redis | ElastiCache for Redis 7(禁用集群模式并启用 Multi-AZ 复制,或启用集群模式并使用 |
存储 | 同区域的 S3 存储桶 |
负载均衡器 | ALB,配置 |
密钥 | AWS Secrets Manager |
Registry pull credentials
Secrets Manager + ECR pull-through cache, or a private repository mirroring registry.containers.tiny.cloud
在 Amazon EKS Auto Mode 中,Pod 使用集群的主安全组(Amazon EKS 管理的集群安全组),而不是节点安全组。允许来自集群主安全组的数据库和 Redis 入站流量。如果使用错误的安全组,AI 服务 Pod 将保持未就绪状态且不输出任何日志。
Azure (AKS)
在 Azure Kubernetes Service 上部署,使用 Azure Database for PostgreSQL Flexible Server、Azure Cache for Redis 和 Azure Blob Storage。服务形态注意事项:
STORAGE_DRIVER=azure是 Azure 上推荐的存储后端。PostgreSQL Flexible Server 默认强制启用 TLS — 请参阅 已知的 TLS 错误界面。
AI 服务不使用 Workload Identity 或托管标识来处理 LLM 凭证 — 在
PROVIDERS中内联 Azure OpenAI 凭证(参见 Azure OpenAI)。
有关 AKS 集群设置、节点池和网络配置,请参阅 Azure Kubernetes Service 文档。
GCP (GKE)
在 Google Kubernetes Engine(Standard 模式 — 非 Autopilot)上部署,使用 Cloud SQL for PostgreSQL、Memorystore for Redis 和 GCS 进行文件存储。服务形态注意事项:
不存在原生 GCS 驱动。通过 S3 互操作性使用 GCS(
STORAGE_DRIVER=s3配合 HMAC 凭证)。存储桶必须禁用uniform_bucket_level_access(SDK 会发送x-amz-acl头)。AI 服务不使用 GKE Workload Identity 或 Application Default Credentials — 在
PROVIDERS中内联 Vertex SA 凭证(参见 Google Vertex AI)。Cloud SQL for PostgreSQL 默认强制启用 TLS — 请参阅 已知的 TLS 错误界面。
有关 GKE 集群创建和节点池配置,请参阅 Google Kubernetes Engine 文档。
网络要求
AI 服务需要对以下端点进行出站 HTTPS 访问。请配置防火墙规则和安全组以允许此流量:
| 端点 | 用途 | 必需 |
|---|---|---|
LLM provider APIs(例如 | 将 AI 请求转发到配置的 provider | 是 |
| 许可证密钥验证(启动时的电话回家检查) | 是 — 如果被阻止,服务将无法启动 |
| 拉取容器镜像更新 | 是(部署时) |
如果部署环境默认阻止所有出站流量,请在启动服务之前将这些添加到出站允许列表中。
许可证验证请求仅传输许可证密钥和服务标识符。不包含对话内容、用户数据或使用指标。每次容器启动时都会进行此检查;如果无法连接到 license.containers.tiny.cloud,服务将不会启动。
安全加固
| 实践 | 实现 |
|---|---|
网络隔离 | 将 AI 服务放置在私有子网中;仅通过负载均衡器暴露。将数据库和 Redis 限制为 AI 服务安全组。 |
阻止面板从公共互联网访问 | 将 |
处处使用 TLS | 在反向代理处终止 TLS 1.3。在支持的情况下,在 AI 服务和数据层之间使用内部相互 TLS(mTLS)。 |
密钥管理 | 使用 Vault、AWS Secrets Manager、Azure Key Vault 或 GCP Secret Manager。切勿将密钥直接存储在编排清单中或提交到源代码控制。 |
静态数据库加密 | 在云提供商控制台中启用静态加密。RDS、Cloud SQL 和 Azure Database 默认启用此功能。 |
Redis 身份验证 | 始终设置 |
容器安全 | 以非 root 用户运行,尽可能使用只读文件系统,并丢弃不必要的 Linux 功能。 |
镜像扫描 | 使用 Trivy、Snyk 或注册表内置扫描器扫描 |
最小权限 JSON Web Tokens (JWTs) | 仅授予每个用户角色所需的权限。避免在生产环境中使用完全访问令牌。 |
API 密钥轮换 | 定期创建新的访问密钥,将新密钥添加到配置中,然后撤销旧密钥。令牌端点在请求时读取密钥。 |
审计日志记录 | 设置 |
大语言模型(LLM)API 密钥轮换 | 将新密钥添加到 |
上述密钥管理、加密和可观测性建议适用于所有云服务商,包括 Azure(AKS、Azure Database、Azure Cache)和 GCP(GKE、Cloud SQL、Memorystore)。
速率限制
AI 服务未内置速率限制功能。请使用反向代理、WAF 或 CDN 在服务前置配置速率限制规则(基于 Authorization 请求头或 JWT 的 sub 声明)。对于租户级别的速率限制,可通过反向代理解析 aud 声明作为键值,或在令牌端点限制每租户每分钟的令牌签发量。具体实现请参考平台文档(nginx limit_req_zone、AWS WAF 基于速率的规则、Cloudflare 速率限制)。
可观测性
健康监控
轮询每个实例的 /health 端点确认运行状态。健康实例将返回 HTTP 200 响应。
curl -f http://ai-service:8000/health
结构化指标日志
设置 ENABLE_METRIC_LOGS 环境变量以启用 stdout 的请求级 JSON 日志:
-e ENABLE_METRIC_LOGS='true'
启用后,服务将为每个请求生成结构化 JSON 条目。关键字段包括请求持续时间和 HTTP 状态码。这些条目可用于任何支持 JSON 解析的日志聚合系统。
指标日志条目示例{"timestamp":"2026-05-19T10:30:00.123Z","method":"POST","path":"/v1/conversations/abc123/messages","statusCode":200,"durationMs":3421}使用 docker logs ai-service --tail 5 | jq . 检查前几条日志条目,了解当前服务版本的所有可用字段。OpenTelemetry
-e LLM_TELEMETRY_ENABLED='true' \
-e OTEL_EXPORTER_OTLP_TRACES_ENDPOINT='http://otel-collector:4318/v1/traces' \
-e OTEL_TRACES_SAMPLER_ARG='1.0' \
-e OTEL_DEBUG='true'
| 变量 | 必需 | 默认值 | 描述 |
|---|---|---|---|
| 是 |
| 主遥测开关 |
| 是 | - | OpenTelemetry 协议(OTLP)端点 URL |
| 否 |
| 采样率(0.0 至 1.0) |
| 否 | - | 详细 OTLP 诊断日志记录 |
兼容 Jaeger、Grafana Tempo、Datadog、New Relic、Honeycomb 及任何 OTLP 兼容 后端。
Langfuse
Langfuse 提供 AI 专用可观测性功能:令牌用量、每次 LLM 调用的延迟、提示词质量评分及成本追踪。
-e LANGFUSE_PUBLIC_KEY='pk-lf-...' \
-e LANGFUSE_SECRET_KEY='sk-lf-...' \
-e LANGFUSE_BASE_URL='https://cloud.langfuse.com' \
-e LANGFUSE_DEBUG='true'
| 变量 | 必需 | 默认值 | 描述 |
|---|---|---|---|
| 是(如使用) | - | Langfuse 公钥 |
| 是(如使用) | - | Langfuse 密钥 |
| 否 |
| 自托管 Langfuse URL |
| 否 | - | 详细 Langfuse 日志记录 |
Langfuse 还需设置 LLM_TELEMETRY_ENABLED=true。若服务版本使用 OTLP 管道导出到 Langfuse,还需配置有效的 OTEL_EXPORTER_OTLP_TRACES_ENDPOINT;请查看部署版本的发行说明。
OpenTelemetry 和 Langfuse 可同时运行,服务会无冲突地向两者输出数据。
分布式日志
对于生产环境多实例部署,请将容器日志传输至现有日志聚合系统。ENABLE_METRIC_LOGS 选项生成的指标日志已是结构化 JSON,可在任何管道中干净解析。具体日志驱动或 DaemonSet 配置请参考平台文档(CloudWatch、Fluent Bit、Promtail、Filebeat 或 Docker fluentd 日志驱动)。
推荐监控
以下检查项有助于尽早发现常见问题:
健康端点:轮询每个实例的
/health;若任一实例持续超过 60 秒返回非 200 响应则触发告警。错误率:监控指标日志或链路追踪中的 HTTP 5xx 速率;持续上升可能表明 LLM 提供商故障或环境配置错误。
延迟:跟踪请求持续时间;突然上升通常表明 LLM 提供商限流或网络问题。
容器重启:针对重复的容器重启发出警报,这可能表明缺少环境变量或数据库连接存在问题。
如需排查特定错误模式,请参阅故障排除。
备份与恢复
数据库
数据库包含环境、访问密钥、对话、消息和文件元数据。请使用标准生产实践备份数据库:
MySQL:使用
mysqldump或托管快照(RDS自动备份)。PostgreSQL:使用
pg_dump或托管快照。
启用时间点恢复。
文件存储
| 后端 | 备份方式 |
|---|---|
| SQL数据库存储文件blob;数据库备份包含这些内容。 |
| 备份挂载卷。 |
| 在存储桶上启用版本控制以进行时间点恢复。 |
| 启用Blob版本控制。 |
Redis
Redis存储临时状态。丢失Redis数据不会影响持久数据。无需备份。
升级流程
拉取新镜像:
docker pull registry.containers.tiny.cloud/ai-service-tiny:NEW_VERSION
对于跨版本边界的滚动部署:先启动一个新版本实例,待其健康后再滚动更新其余实例。
对于Kubernetes:更新Deployment中的镜像标签。设置
strategy.rollingUpdate.maxSurge: 1和maxUnavailable: 0,确保迁移期间至少有一个旧Pod保持可用。默认RollingUpdate策略可实现零停机升级,前提是第一个新Pod在继续发布前达到Ready状态。在宣布升级完成前,验证每个副本的
/health状态。
升级前请查看目标版本的发行说明并备份数据库。
许可证密钥按部署分配,而非按副本分配。一个密钥可覆盖单个部署的任意数量副本。